<<深入刨析Kubernetes>>读书记录
重新认识容器
简单的说:
容器可以被一分为二的看待
一组联合挂载在/var/lib/docker/overlay2上的rootfs,这部分称为容器镜像(image)
一个由Namspace+Cgroup隔离构成的隔特殊的进程,这部分称为容器运行时(runtime)
容器是一种特殊的进程,它通过Namespace,Cgroup,Union Mount 技术施加了障眼法,让容器中只能看到它想给你看到的信息。
(1)Linux Namespace-负责隔离进程:
Mount Namespace 用于让被隔离只看到当前挂载点的信息,
Network Namespace用于让被隔离的进程只看到当前Namespace里的网络和配置。
创建容器时,会指定一组namespace参数,这样容器中将只能看到当前“namespace”所限定的资源,文件,设备,状态配置等信息。其应用进程是容器中PID=1的进程,也是后续创建容器中其他进程的父进程。这意味着当PID=1的进程退出时,容器也就退出了。容器和应用进程”同生共死“,这个特性在后续对容器编排中起到了很大的作用,也意味着一个容器无法运行两个不同的应用,除非有一个公共的PID=1的程序来充当两个不同应用的父进程。
所以对于宿主机来说,容器和其他的进程并没有本质区别,不像在虚拟机中对隔离的应用进程直接直接负责的是Hypervisor,在容器中对隔离环境真正负责的是宿主机,所以多个容器都共享宿主机的操作系统内核,不用像虚拟机那样每个隔离环境都需要单独的客户操作系统,这是容器“轻量”的一个原因。另外由于容器并不是完整的操作系统,容器内部并不需要其内核,不需要定位,解压,初始化,也不需要有内核启动过程中对硬件的遍历和初始化,只需要宿主机操作系统的共享内核是启动的,所以唯一对容器启动时间有影响的就是容器内应用启动所花费的时间。这是也容器可以秒级启动的原因.
实际上,进程的每种Linux Namespace 都在它对应的proc/[进程号]/ns下的虚拟文件中,连接到一个真实的namespace文件上,这意味着,一个进程可以选择加入某个进程的namespace中,这也是docker exec的原理,这个操作依赖了名为setns()的Linux系统调用
Namespace隔离技术相对与虚拟化也有其缺点:主要问题是隔离的不彻底,由于共享宿主机操作系统内核,那么windows宿主机上将不能运行Linux容器,低版本的Linux宿主机也无法运行高版本的Linux容器,拥有硬件虚拟化技术和独立客户操系统的虚拟机就不存在此类问题。其次是很多资源都无法通过Namespace技术来隔离,一个典型例子是“时间”,在容器中的程序使用settimeofday(2)系统调用修改时间,那宿主机上的时间也会被随之修改,这显然不符合预期。
由于共享宿主机内核的事实,容器相对于虚拟机将面临更多的安全问题,所以在生产环境中千万不要把在物理机中运行容器直接暴露到公网上。
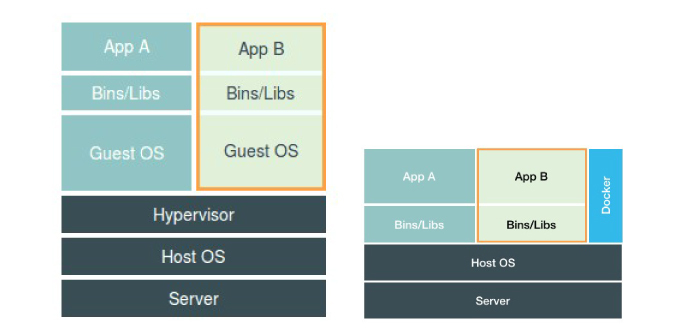
(2)Linux Cgroup -为进程组设置资源上限
Cgroup 以文件和目录的方式组织在操作系统的/sys/fs/cgroup路径下,下面的子目录代表着当前机器可以被限制的资源种类。
1 | [root@VM-12-17-centos cgroup]# pwd |
- cpu:限制进程在某段时间内分配到的cpu时间
- 3blkio:为块设备设置I/O限制,一般用于磁盘等设备
- cpuset:为进程分配单独的CPU核和对应的内存节点
- memory:为进程设定内存使用限制
以cpu为例子,在cpu目录中的docker目录下有两个文件cpu.cfs_period_us和cpu.cfs_quota_us,这两个参数分别组合负责CPU在period时段内的quota用量。
1 | 默认是100ms(100000us) |
/sys/fs/cgroup/cpu/docker这个路径下的task文件负责记录限制的进程PID,写入容器进程在宿主机上的PID后即可对该进程进行限制。
这些参数都可通过在docker run后指定,例如docker run -it --cpu-period=1000 --cpu-quota=20 ubuntu /bin/bash
Cgroup也有很多不完善的地方,比如/proc文件系统的问题。
Linux 下的 /proc 目录存储的是记录当前内核运行状态的一系列特殊文件,用户可以通过访问这些文件,查看系统以及当前正在运行的进程的信息,比如 CPU 使用情况、内存占用率等,这些文件也是 top 指令查看系统信息的主要数据来源。
但是如果你在容器中执行top命令就会发现,它显示的信息居然是宿主机的 CPU 和内存数据,而不是当前容器的数据,造成这个问题的原因就是,/proc文件系统并不知道用户通过Cgroups给容器做了什么样的资源限制,即:**/proc 文件系统不了解 Cgroups 限制的存在。**
这在生产环境中将可能出现问题,例如很多基于JVM的java程序,应用启动时会根据系统的资源上限来分配JVM的堆栈大小,若JVM获取的是物理机资源,而给容器分配的资源又有限,那将导致程序无法成功启动。
使用lxcfs技术可以解决这个问题
lxcfs 是通过文件挂载的方式,把 cgroup 中关于系统的相关信息读取出来,通过 docker 的 volume 挂载给容器内部的 proc 系统。 然后让 docker 内的应用读取 proc 中信息的时候以为就是读取的宿主机的真实的 proc。
上图说明了,当我们把宿主机的 /var/lib/lxcfs/proc/memoinfo 文件挂载到 Docker 容器的 /proc/meminfo 位置后,容器中进程读取相应文件内容时,lxcfs 的 /dev/fuse 实现会从容器对应的 Cgroup 中读取正确的内存限制。从而使得应用获得正确的资源约束。 cpu 的限制原理也是一样的。
(3)联合挂载-理解容器镜像
Namespace的作用是“隔离”,它让应用进程只能“看到”该Namespace内的“世界”,而Cgroup的作用是“限制”,它给这个“世界”围了一圈看不见的墙,如此一来,进程就被装进了一个与世隔绝的“房间”里。
但容器内部是什么样的景象呢?因为Mount namspace 原因,容器内的应用进程应该看到一台完全独立的文件系统,它应该可以在自己的容器目录下操作,不会受到宿主机和其他容器的影响. 这是如何实现的?其实它是在容器启动之前重新挂载了容器的整个根目录,而由于Mount namspace的存在,整个挂载对宿主机不可见。
在Linux中有一个名为chroot的命令,它的作用就是改变进程的根目录到指定的位置,它的用法也非常简单,例如有一个$HOME/test的目录,你想把它作为一个/bin/bash进程的根目录,只用chroot $HOME/test /bin/bash。Mount Namespace 就是通过对chroot不断改良得来的。
为了使容器更加真实,我们一般会在这个容器根目录下挂载一个完整的操作系统的文件系统,这个挂载在容器根目录上用来为容器进程提供隔离后执行的文件系统,就是所谓的“容器镜像”。它另一个名字就是:rootfs(根文件系统)。
通过上述内容也揭示了Docker项目最核心的三个步骤:
- 启动Linux Namespace配置
- 设置指定的Cgroups参数
- 切换进程的根目录(change root)
另外,需要明确的是rootfs只是一个操作系统所包含的文件,配置和目录,并不包含操作系统的内核,在操作系统中这两部分是分开存放的,操作系统开机时才会加载指定版本的内核。
正是由于rootfs的存在,容器有了一个重要特性”一致性“,rootfs打包的不止是应用而是整个操作系统的文件和目录,这意味这,应用以及它所需要运行的依赖都被封装在了一起,这里的依赖不只是编程语言层面的依赖包,而是整个操作系统级的运行环境本身。
这种一致性使得无论是在云端,本地,还是任何一台机器上,只要用户使用打包好的容器镜像,容器所需要的完整执行环境便能重现。
新的问题是若每开发或升级一个容器应用都需要重新制作roots会显得很麻烦,所以若能利用之前制作的rootfs能大大减少重复流程,以增量的方式去修改是一个很好的方法,所有人都只需要维护一个相对较旧的base rootfs,而不是每次修改都重新制造一个,基于此想法Docker在镜像设计中引入了层的概念,用户的每一步操作都会生成一个层,也就是一个增量rootfs。
这种方法用到了一种叫UnionFS的能力,也就是联合挂载(如今使用overlay2),它最主要的功能就是把不同位置的目录挂载到同以目录下。
这样我们就可以把每层都生产一个目录,在需要那些层的同时都集中挂载到同一目录了。
层的信息保存在/var/lib/docker/overlay2/这个目录中。
docker 通过调用containerd(管理容器生命周期stop|pause|start|rm和镜像)+ runc(创建容器 调用namespace,cgroup等工具)。
containerd 指挥 runc 来创建容器,实际上它每次都会fork一个runc实例,容器创建完毕后runc进程就会退出,此时shim将会接管容器。其作用1.保持STDIN和STDOUT是开启的,daemon重启时,容器不会因为管道的关闭而终止 2. 容器退出状态返回给daemon。
容器的价值非常有限,真正有价值的是“容器编排”。
为什么需要Pod
Pod只是一个逻辑概念,Kubernetes 真正处理的,还是宿主机操作系统上 Linux 容器的 Namespace 和 Cgroups,而并不存在一个所谓的 Pod 的边界或者隔离环境。
Pod,其实是一组共享了某些资源的容器。
具体的说:Pod 里的所有容器,共享的是同一个 Network Namespace,并且可以声明共享同一个 Volume。
由于需要保证pod内容器的对等性往往pod实现需要使用一个中间容器,这个让其叫Infra容器。
在这个 Pod 中,Infra 容器永远都是第一个被创建的容器,而其他用户定义的容器,则通过 Join Network
Namespace 的方式,与 Infra 容器关联在一起。
infra容器详解:
infra容器占用资源极少,使用的是一个非常特殊的镜像,k8s.gcr.io/pause用汇编语言编写。
这也就意味着,对于 Pod 里的容器 A 和容器 B 来说:
- 它们可以直接使用 localhost 进行通信;
- 它们看到的网络设备跟 Infra 容器看到的完全一样;
- 一个 Pod 只有一个 IP 地址,也就是这个 Pod 的 Network Namespace 对应的 IP 地址;
- 当然,其他的所有网络资源,都是一个 Pod 一份,并且被该 Pod 中的所有容器共享;
- Pod 的生命周期只跟 Infra 容器一致,而与容器 A 和 B 无关。
Pod类似一台完整的虚拟机功能,自己的网络,存储和内部的容器进程。
Pod生命周期:
Pending 意味着Pod的YAML文件已经提交给了k8s,API对象已经被保存到了etcd中,但是pod内有些容器因为某种原因部能被顺利创建,比如调度不成功
Running 这个状态下,Pod 已经调度成功,跟一个具体的节点绑定。它包含的容器都已经创建成功,并且至
少有一个正在运行中
Succeeded。这个状态意味着,Pod 里的所有容器都正常运行完毕,并且已经退出了。这种情况在运行一次性
任务时最为常见
Failed。这个状态下,Pod 里至少有一个容器以不正常的状态(非 0 的返回码)退出。这个状态的出现,意味
着你得想办法 Debug 这个容器的应用,比如查看 Pod 的 Events 和日志。
Unknown。这是一个异常状态,意味着 Pod 的状态不能持续地被 kubelet 汇报给 kube-apiserver,这很有可
能是主从节点(Master 和 Kubelet)间的通信出现了问题。
仔细阅读$GOPATH/src/k8s.io/kubernetes/vendor/k8s.io/api/core/v1/types.go 里,type Pod struct ,尤其是
PodSpec 部分的内容
Project Volume
- Secret;
- ConfigMap;
- Downward API;
- ServiceAccountToken。
Pod容器健康检查和恢复机制
Kubelet根据“探针” Probe的返回值来决定这个容器的状态,而不是以容器是否运行作为根据。
例如
1 | apiVersion: v1 |
我们定义了一个这样的 livenessProbe(健康检查)。它的类型是 exec,这意味着,它会在容器启动后,在容器
里面执行一句我们指定的命令,比如:“cat /tmp/healthy”。这时,如果这个文件存在,这条命令的返回值就是
0,Pod 就会认为这个容器不仅已经启动,而且是健康的。这个健康检查,在容器启动 5 s 后开始执行
(initialDelaySeconds: 5),每 5 s 执行一次(periodSeconds: 5)。
Pod的恢复机制永远发生在当前节点上,而不会跑到其他节点上,如果想让pod出现在其他节点上,必须使用Deployment 控制器来管理pod。
而作为用户,你还可以通过设置 restartPolicy,改变 Pod 的恢复策略。除了 Always,它还有 OnFailure 和 Never 两种情况:
- Always:在任何情况下,只要容器不在运行状态,就自动重启容器;
- OnFailure: 只在容器 异常时才自动重启容器;
- Never: 从来不重启容器。
值得一提的是,Kubernetes 的官方文档,把 restartPolicy 和 Pod 里容器的状态,以及 Pod 状态的对应关系,总结了非常复杂的一大堆情况。实际上,你根本不需要死记硬背这些对应关系,只要记住如下两个基本的设计原理即可:
- 只要 Pod 的 restartPolicy 指定的策略允许重启异常的容器(比如:Always),那么这个 Pod 就会保持 Running 状态,并进行容器重启。否则,Pod 就会进入 Failed 状态 。
- 对于包含多个容器的 Pod,只有它里面所有的容器都进入异常状态后,Pod 才会进入 Failed 状态。在此之前,Pod 都是 Running 状态。此时,Pod 的 READY 字段会显示正常容器的个数,
在 Kubernetes 的 Pod 中,还有一个叫 readinessProbe 的字段。虽然它的用法与 livenessProbe 类似,但作用
却大不一样。readinessProbe 检查结果的成功与否,决定的这个 Pod 是不是能被通过 Service 的方式访问到,而
并不影响 Pod 的生命周期。
Pod 两种探针简介
- LivenessProbe(存活探针): 存活探针主要作用是,用指定的方式进入容器检测容器中的应用是否正常运行,如果检测失败,则认为容器不健康,那么
Kubelet将根据Pod中设置的restartPolicy(重启策略)来判断,Pod 是否要进行重启操作,如果容器配置中没有配置livenessProbe存活探针,Kubelet将认为存活探针探测一直为成功状态。 - ReadinessProbe(就绪探针): 用于判断容器中应用是否启动完成,当探测成功后才使 Pod 对外提供网络访问,设置容器
Ready状态为true,如果探测失败,则设置容器的Ready状态为false。对于被 Service 管理的 Pod,Service与Pod、EndPoint的关联关系也将基于 Pod 是否为Ready状态进行设置,如果 Pod 运行过程中Ready状态变为false,则系统自动从Service关联的EndPoint列表中移除,如果 Pod 恢复为Ready状态。将再会被加回Endpoint列表。通过这种机制就能防止将流量转发到不可用的 Pod 上。
Pod 探针的探测方式与结果
目前 LivenessProbe 和 ReadinessProbe 两种探针都支持下面三种探测方法:
- ExecAction: 在容器中执行指定的命令,如果能成功执行,则探测成功。
- HTTPGetAction: 通过容器的IP地址、端口号及路径调用 HTTP Get 方法,如果响应的状态码 200 ≤ status ≤ 400,则认为容器探测成功。
- TCPSocketAction: 通过容器的 IP 地址和端口号执行 TCP 检查,如果能够建立 TCP 连接,则探测成功。
探针探测结果有以下值:
Success:表示通过检测。
Failure:表示未通过检测。
Unknown:表示检测没有正常进行。
Pod 探针的相关属性
两种探针有许多可选字段,可以用来更加精确的控制 LivenessProbe 和 ReadinessProbe 两种探针的探测,具体如下:
- initialDelaySeconds: Pod 启动后首次进行检查的等待时间,单位“秒”。
- periodSeconds: 检查的间隔时间,默认为 10s,单位“秒”。
- timeoutSeconds: 探针执行检测请求后,等待响应的超时时间,默认为 1s,单位“秒”。
- successThreshold: 探针检测失败后认为成功的最小连接成功次数,默认为 1s,在 Liveness 探针中必须为 1s,最小值为 1s。
- failureThreshold: 探测失败的重试次数,重试一定次数后将认为失败,在 readiness 探针中,Pod会被标记为未就绪,默认为 3s,最小值为 1s。
两种探针的区别
总的来说 ReadinessProbe 和 LivenessProbe 是使用相同探测的方式,只是探测后对 Pod 的处置方式不同:
- ReadinessProbe: 当检测失败后,将 Pod 的 IP:Port 从对应 Service 关联的 EndPoint 地址列表中删除。
- LivenessProbe: 当检测失败后将杀死容器,并根据 Pod 的重启策略来决定作出对应的措施。
备注:endpoint是k8s集群中的一个资源对象,存储在etcd中,用来记录一个service对应的所有pod的访问地址。service配置selector,endpoint controller才会自动创建对应的endpoint对象;否则,不会生成endpoint对象.
例如,k8s集群中创建一个名为hello的service,就会生成一个同名的endpoint对象,ENDPOINTS就是service关联的pod的ip地址和端口。
“控制器”的思想
Deployment 对象中 Replicas 字段的值。很明显,这些信息往往都保存在 Etcd 中。
接下来,以 Deployment 为例,我和你简单描述一下它对控制器模型的实现:
- Deployment 控制器从 Etcd 中获取到所有携带了“app: nginx”标签的 Pod,然后统计它们的数量,这就是实际状态;
- Deployment 对象的 Replicas 字段的值就是期望状态;
- Deployment 控制器将两个状态做比较,然后根据比较结果,确定是创建 Pod,还是删除已有的 Pod(具体如何操作 Pod 对象,我会在下一篇文章详细介绍)。
可以看到,一个 Kubernetes 对象的主要编排逻辑,实际上是在第三步的“对比”阶段完成的。
这个操作,通常被叫作调谐(Reconcile)。这个调谐的过程,则被称作“Reconcile Loop”(调谐循环)或者“Sync Loop”(同步循环)。
水平扩展
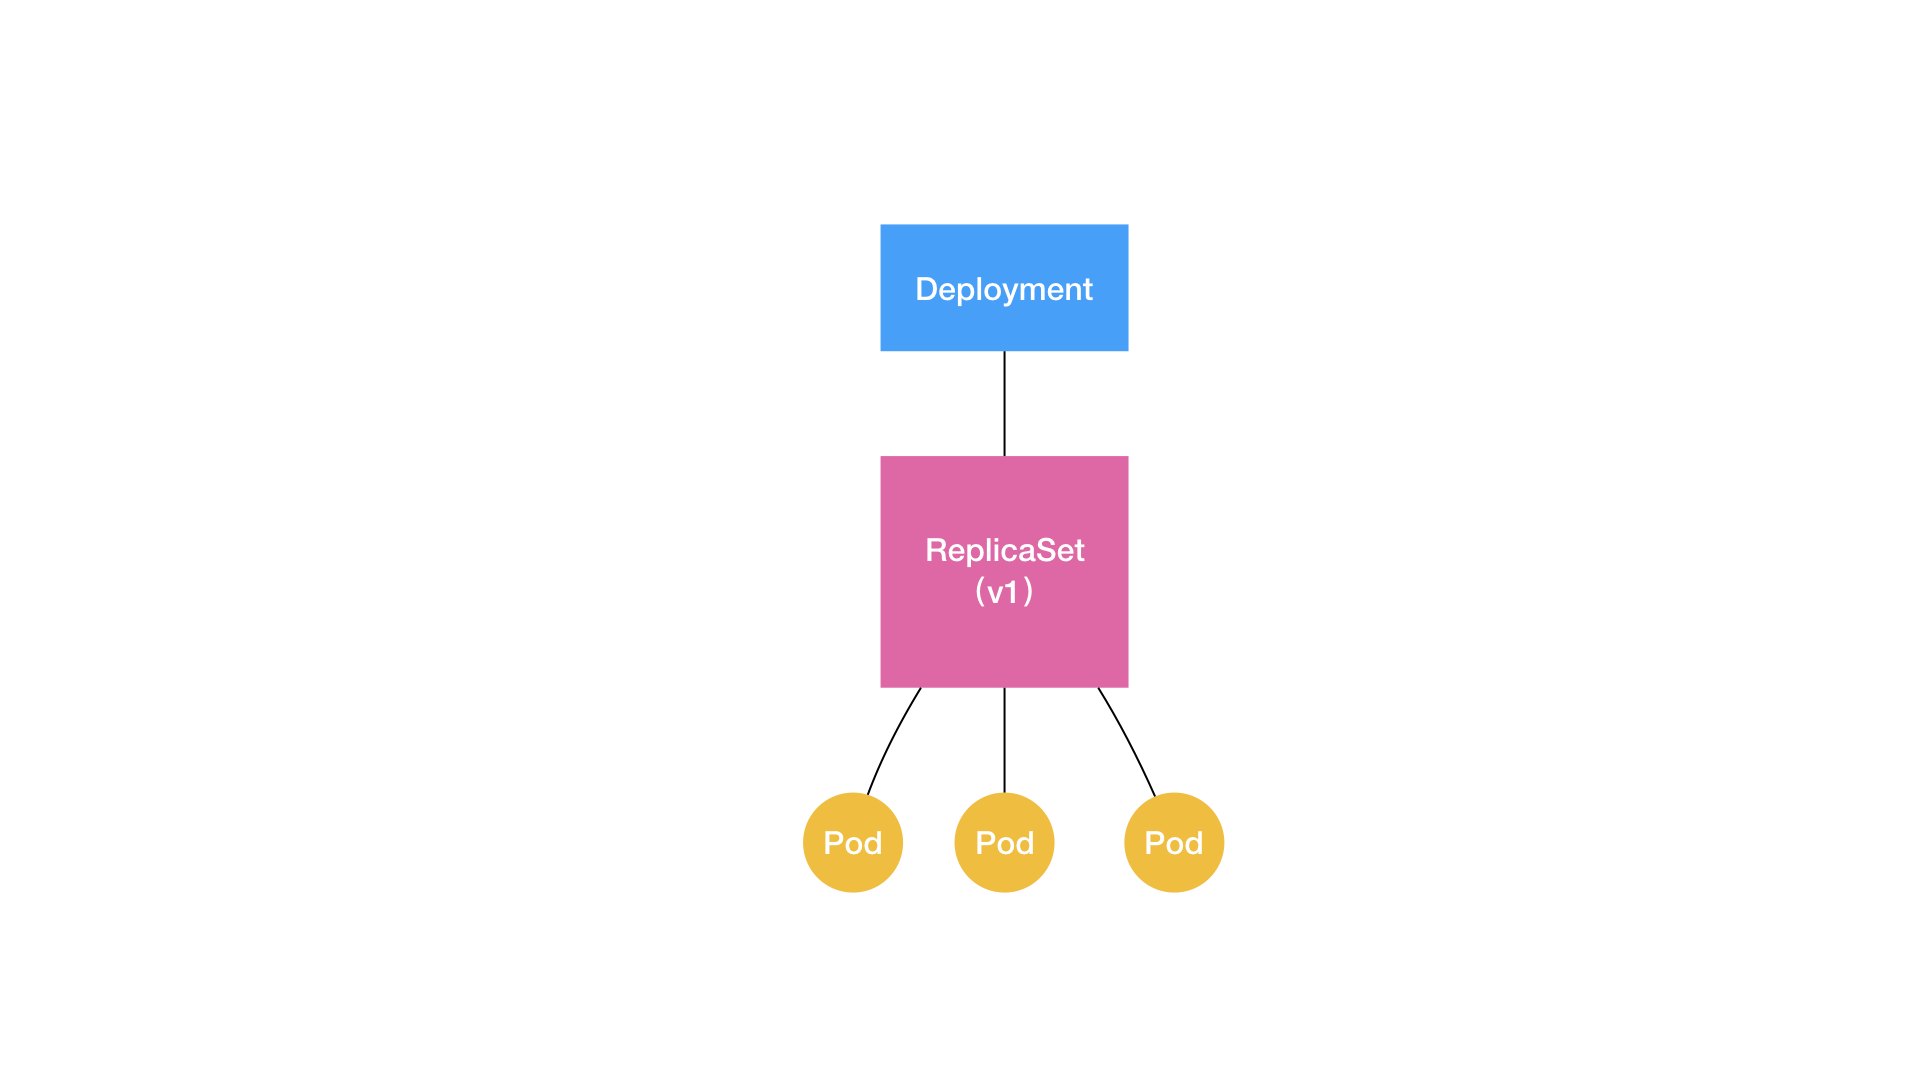
通过这张图,我们就很清楚的看到,一个定义了 replicas=3 的 Deployment,与它的 ReplicaSet,以及 Pod 的关系,实际上是一种“层层控制”的关系。
其中,ReplicaSet 负责通过“控制器模式”,保证系统中 Pod 的个数永远等于指定的个数(比如,3 个)。这也正是 Deployment 只允许容器的 restartPolicy=Always 的主要原因:只有在容器能保证自己始终是 Running 状态的前提下,ReplicaSet 调整 Pod 的个数才有意义。
而在此基础上,Deployment 同样通过“控制器模式”,来操作 ReplicaSet 的个数和属性,进而实现“水平扩展 / 收缩”和“滚动更新”这两个编排动作。
其中,“水平扩展 / 收缩”非常容易实现,Deployment Controller 只需要修改它所控制的 ReplicaSet 的 Pod 副本个数就可以了。
比如,把这个值从 3 改成 4,那么 Deployment 所对应的 ReplicaSet,就会根据修改后的值自动创建一个新的 Pod。这就是“水平扩展”了;“水平收缩”则反之。
而用户想要执行这个操作的指令也非常简单,就是 kubectl scale,比如:
1 | kubectl scale deployment nginx-deployment --replicas=4 |
滚动更新
用户在提交一个deployment对象后,deployment Controller立即创建一个Pod副本为X的ReplicaSet。
使用kubect edit 修改了 Deployment 里的 Pod 定义之后,Deployment Controller 会使用这个修改后的 Pod 模板,创建一个新的 ReplicaSet(hash=1764197365),这个新的 ReplicaSet 的初始 Pod 副本数是:0。
新 ReplicaSet 管理的 Pod 副本数,从 0 个变成 1 个,再变成 2 个,最后变成 3 个。而旧的 ReplicaSet 管理的 Pod 副本数则从 3 个变成 2 个,再变成 1 个,最后变成 0 个。这样,就完成了这一组 Pod 的版本升级过程。
像这样,将一个集群中正在运行的多个 Pod 版本,交替地逐一升级的过程,就是“滚动更新”
备注:kubectl edit 并不神秘,它不过是把 API 对象的内容下载到了本地文件,让你修改完成后再提交上去。
Deployment 的控制器,实际上控制的是 ReplicaSet 的数目,以及每个 ReplicaSet 的属性。
而一个应用的版本,对应的正是一个 ReplicaSet;这个版本应用的 Pod 数量,则由 ReplicaSet 通过它自己的控制器(ReplicaSet Controller)来保证。
回滚命令
kubectl rollout undo
kubectl rollout status xxx
每次对deployment进行操作都会生产一个新的ReplicaSet对象,若你在更新Deployment 前,你要先执行一条
kubectl rollout pause 指令,再修改Deployment里的内容就不会创建新的ReplicaSet。
之后再执行一条 kubectl rollout resume 指令,就可以恢复Deployment
Deployment 对象有一个字段,叫作 spec.revisionHistoryLimit,就是 Kubernetes 为 Deployment 保留的“历史版本”个数。所以,如果把它设置为 0,你就再也不能做回滚操作了。
通过这些讲解,你应该了解到:Deployment 实际上是一个两层控制器。首先,它通过ReplicaSet 的个数来描述应用的版本;然后,它再通过ReplicaSet 的属性(比如 replicas 的值),来保证 Pod 的副本数量。
备注:Deployment 控制 ReplicaSet(版本),ReplicaSet 控制 Pod(副本数)。这个两层控制关系一定要牢记。
金丝雀发布和蓝绿发布也是基于Deployment实现的。(滚动更新很像自动更新的金丝雀发布)
[k8s-deployment-strategies/canary at master · ContainerSolutions/k8s-deployment-strategies · GitHub](
声明式API
作为用户,当然最希望容器编排系统能自动把所有意外因素都消灭掉,让任何每一个服务都永远健康,永不出错。但永不出错的服务是不切实际的,只有凑齐七颗龙珠才有望办到。那就只能退而求其次,让编排系统在这些服务出现问题,运行状态不正确的时候,能自动将它们调整成正确的状态。这种需求听起来也是贪心的,却已经具备足够的可行性,应对的解决办法在工业控制系统里已经有非常成熟的应用,叫作控制回路(Control Loop)。
Kubernetes 官方文档是以房间中空调自动调节温度为例子介绍了控制回路的一般工作过程的:当你设置好了温度,就是告诉空调你对温度的“期望状态”(Desired State),而传感器测量出的房间实际温度是“当前状态”(Current State)。根据当前状态与期望状态的差距,控制器对空调制冷的开关进行调节控制,就能让其当前状态逐渐接近期望状态。
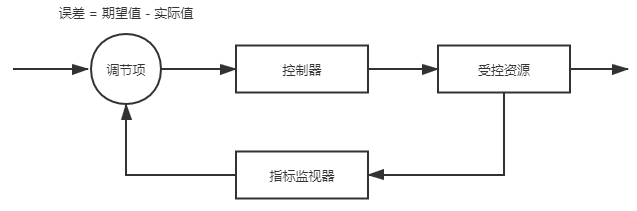 图 11-5 控制回路
将这种控制回路的思想迁移应用到容器编排上,自然会为 Kubernetes 中的资源附加上了期望状态与实际状态两项属性。不论是已经出现在上节的资源模型中,用于抽象容器运行环境的计算资源,还是没有登场的另一部分对应于安全、服务、令牌、网络等功能的资源,用户要想使用这些资源来实现某种需求,并不提倡像平常编程那样去调用某个或某一组方法来达成目的,而是通过描述清楚这些资源的期望状态,由 Kubernetes 中对应监视这些资源的控制器来驱动资源的实际状态逐渐向期望状态靠拢,以此来达成目的。这种交互风格被称为是 Kubernetes 的声明式 API,如果你已有过实际操作 Kubernetes 的经验,那你日常在元数据文件中的spec字段所描述的便是资源的期望状态。
滚动更新
将这个过程放到 ReplicaSet 上,就是先创建新版本的 ReplicaSet,然后一边让新 ReplicaSet 逐步创建新版 Pod 的副本,一边让旧的 ReplicaSet 逐渐减少旧版 Pod 的副本。
之所以kubectl rolling-update命令会被淘汰,是因为这样的命令式交互完全不符合 Kubernetes 的设计理念(这是台面上的说法,笔者觉得淘汰的根本原因主要是因为它不够好用),如果你希望改变某个资源的某种状态,应该将期望状态告诉 Kubernetes,而不是去教 Kubernetes 具体该如何操作。因此,新的部署资源(Deployment)与部署控制器被设计出来,可以由 Deployment 来创建 ReplicaSet,再由 ReplicaSet 来创建 Pod,当你更新 Deployment 中的信息(譬如更新了镜像的版本)以后,部署控制器就会跟踪到你新的期望状态,自动地创建新 ReplicaSet,并逐渐缩减旧的 ReplicaSet 的副本数,直至升级完成后彻底删除掉旧 ReplicaSet
如果你觉得已经理解了前面的几种资源和控制器的例子,那不妨思考一下以下几个问题:假设我想限制某个 Pod 持有的最大存储卷数量,应该会如何设计?假设集群中某个 Node 发生硬件故障,Kubernetes 要让调度任务避开这个 Node,应该如何设计?假设一旦这个 Node 重新恢复,Kubernetes 要能尽快利用上面的资源,又该如何去设计?只要你真正接受了资源与控制器是贯穿整个 Kubernetes 的两大设计理念,即便不去查文档手册,也应该能推想出个大概轮廓,以此为基础当你再去看手册或者源码时,想必就能够事半功倍
http://icyfenix.cn/immutable-infrastructure/container/container-build-system.html
容器网络模型
单机容器网络模型 - docker0网桥
在前面讲解容器基础时,我曾经提到过一个 Linux 容器能看见的“网络栈”,实际上是被隔离在它自己的 Network Namespace 当中的。
而所谓“网络栈”,就包括了:网卡(Network Interface)、回环设备(Loopback Device)、路由表(Routing Table)和 iptables 规则。对于一个进程来说,这些要素,其实就构成了它发起和响应网络请求的基本环境。
作为容器 可以直接使用宿主机的网络栈。-net host 即不开启Network Namespace(端口可能不够用)。
这个被隔离的容器进程,该如何跟其他 Network Namespace 里的容器进程进行交互呢?
想要若实现两台主机之间通信,最简单的方法就是通过网线连接起来,若多台主机相互通信则需要网线连接在一台交换机上。
在 Linux 中,能够起到虚拟交换机作用的网络设备,是网桥(Bridge)。它是一个工作在数据链路层(Data Link)的设备,主要功能是根据 MAC 地址学习来将数据包转发到网桥的不同端口(Port)上。
可以把容器看作一台主机,为实现不同容器的通信,docker会在宿主机上创建一个叫docker0的网桥,充当虚拟交换机的作用,所有与docker0网桥相连接的容器都可以通过它来进行通信。
如何把这些容器连接到docker0网桥上呢?
这使用到了一种叫Veth Pair的虚拟设备,它被创建后总是成对存在,其中一张网卡发出的数据包 会之间出现在对应的网卡上,哪怕是在不同的Network Namespace种。
每当有容器被创建,docker0上就会多出一张与容器eth0网卡对应的veth pair网卡,此时该虚拟设备会降级成docker0网桥上的一个端口
Veth Pair 解释
同宿主机不同容器通信流程:
有两容器nginx01 172.17.0.2与nginx02 172.17.0.3
nginx01 首先通过eth0网卡(veth Pair)发送一个ARP请求,来通过nginx02的ip查找到对应MAC地址,由于eth0网卡是一个veth pair docker0会充当二层交换机的角色,把ARP转发到其他通过veth Pair 与docker0相连的网卡上,这样同样连接在docker0上的nginx02就会接受到ARP(包含nginx01的ip和MAC地址),然后把自己的MAC地址直接回复给ngxin01容器。
nginx01获得nginx02的MAC地址后,根据veth pair eth0发送的数据包将首先通过docker0网桥,docker0网桥根据目的MAC地址(nginx02)在它的CAM表(存放端口和MAC地址的关系)查询到nginx02的插在docker0上的veth端口(即网卡) 然后通过其发送给nginx02.
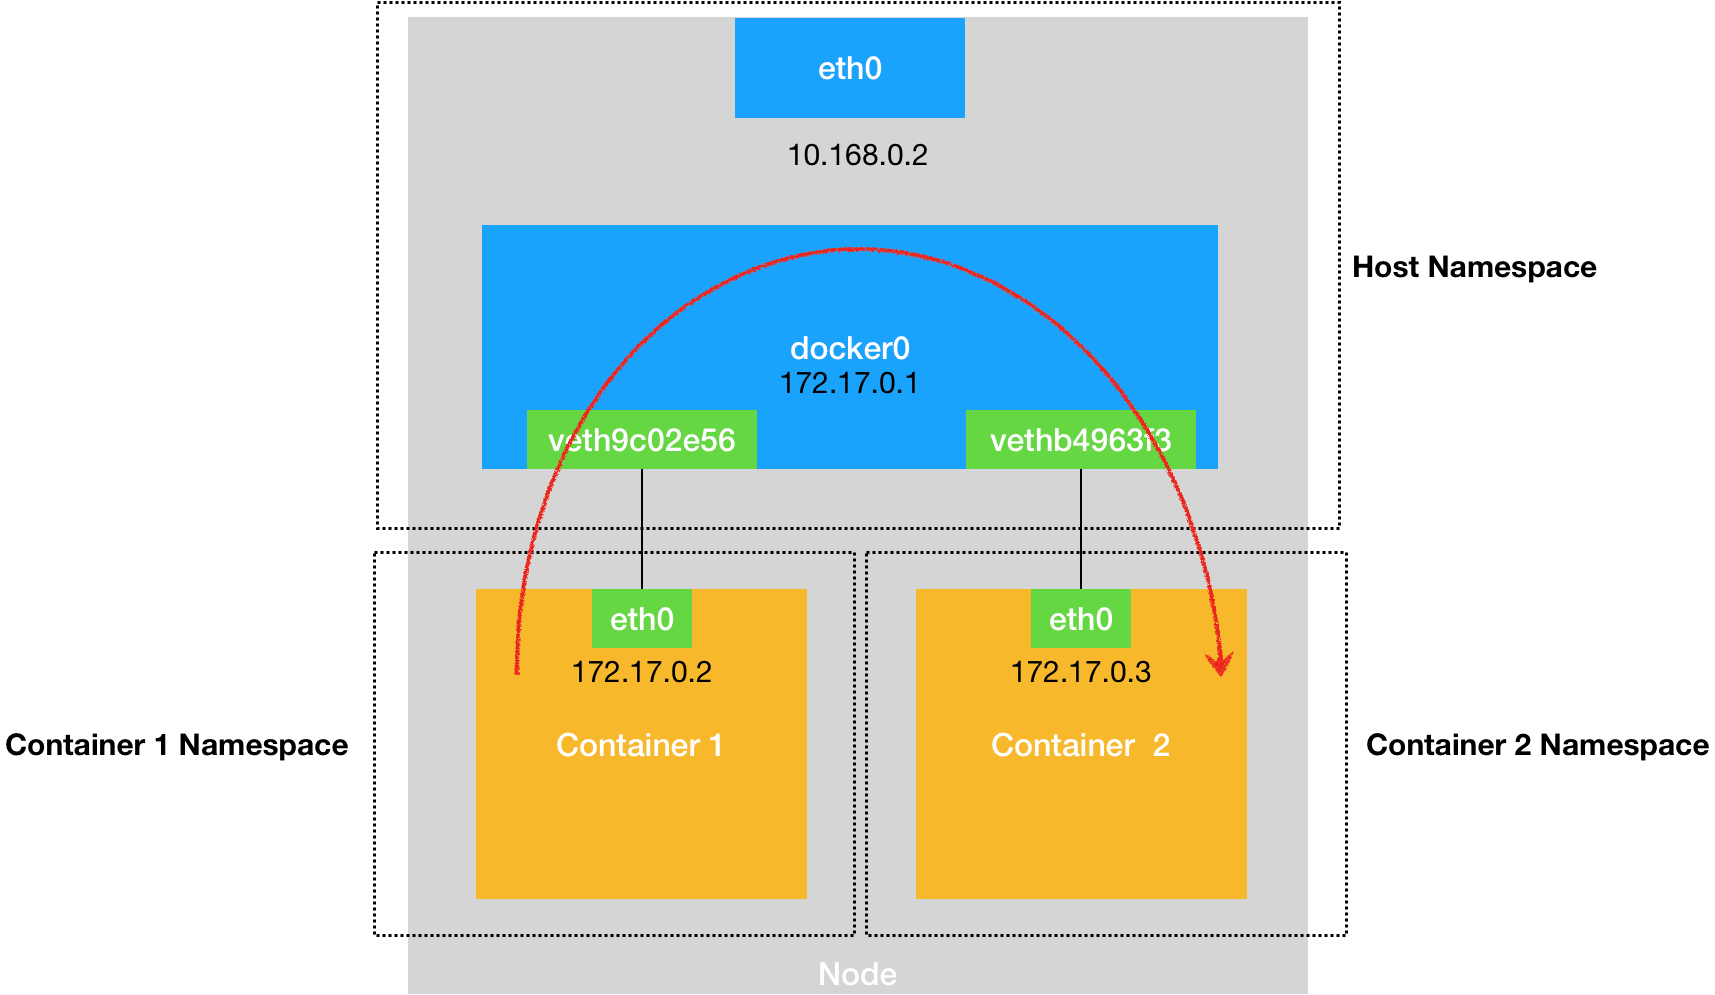
容器与其他宿主机通信:
容器试图与其他宿主机连接时,数据包首先会发往docker0,通过NAT转发到宿主机的网卡上,然后宿主机网卡根据路由表规则转发到对应的网络上。
所以说,当你遇到容器连不通“外网”的时候,你都应该先试试 docker0 网桥能不能 ping 通,然后查看一下跟 docker0 和 Veth Pair 设备相关的 iptables 规则是不是有异常,往往就能够找到问题的答案了
跨主机容器网络模型 - 覆盖网络
对于不同宿主机上的不同容器想要通信,通常创建一个整个集群公用的公共网桥,然后把所有容器都连接到网桥上,构建这种容器网络的核心在于:我们需要在已有的宿主机网络上,再通过软件构建一个覆盖在已有宿主机网络之上的、可以把所有容器连通在一起的虚拟网络这就叫覆盖网络
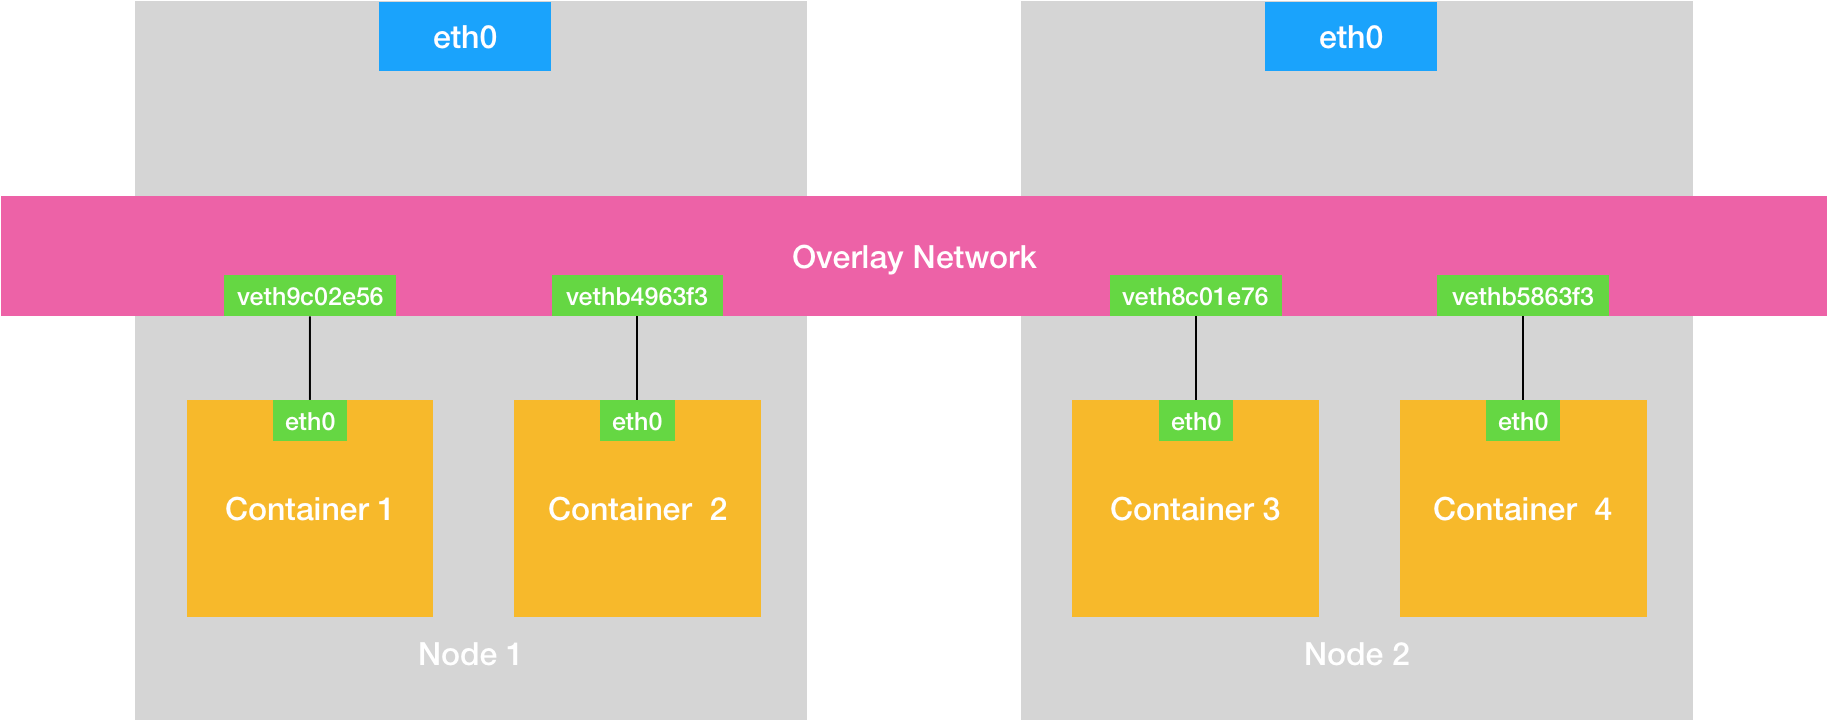
Flannel 支持的三种容器跨主机网络主流方案
- VXLAN;
- host-gw;
- UDP(性能问题 被弃用)
基于 Flannel UDP 模式的跨主通信的基本原理
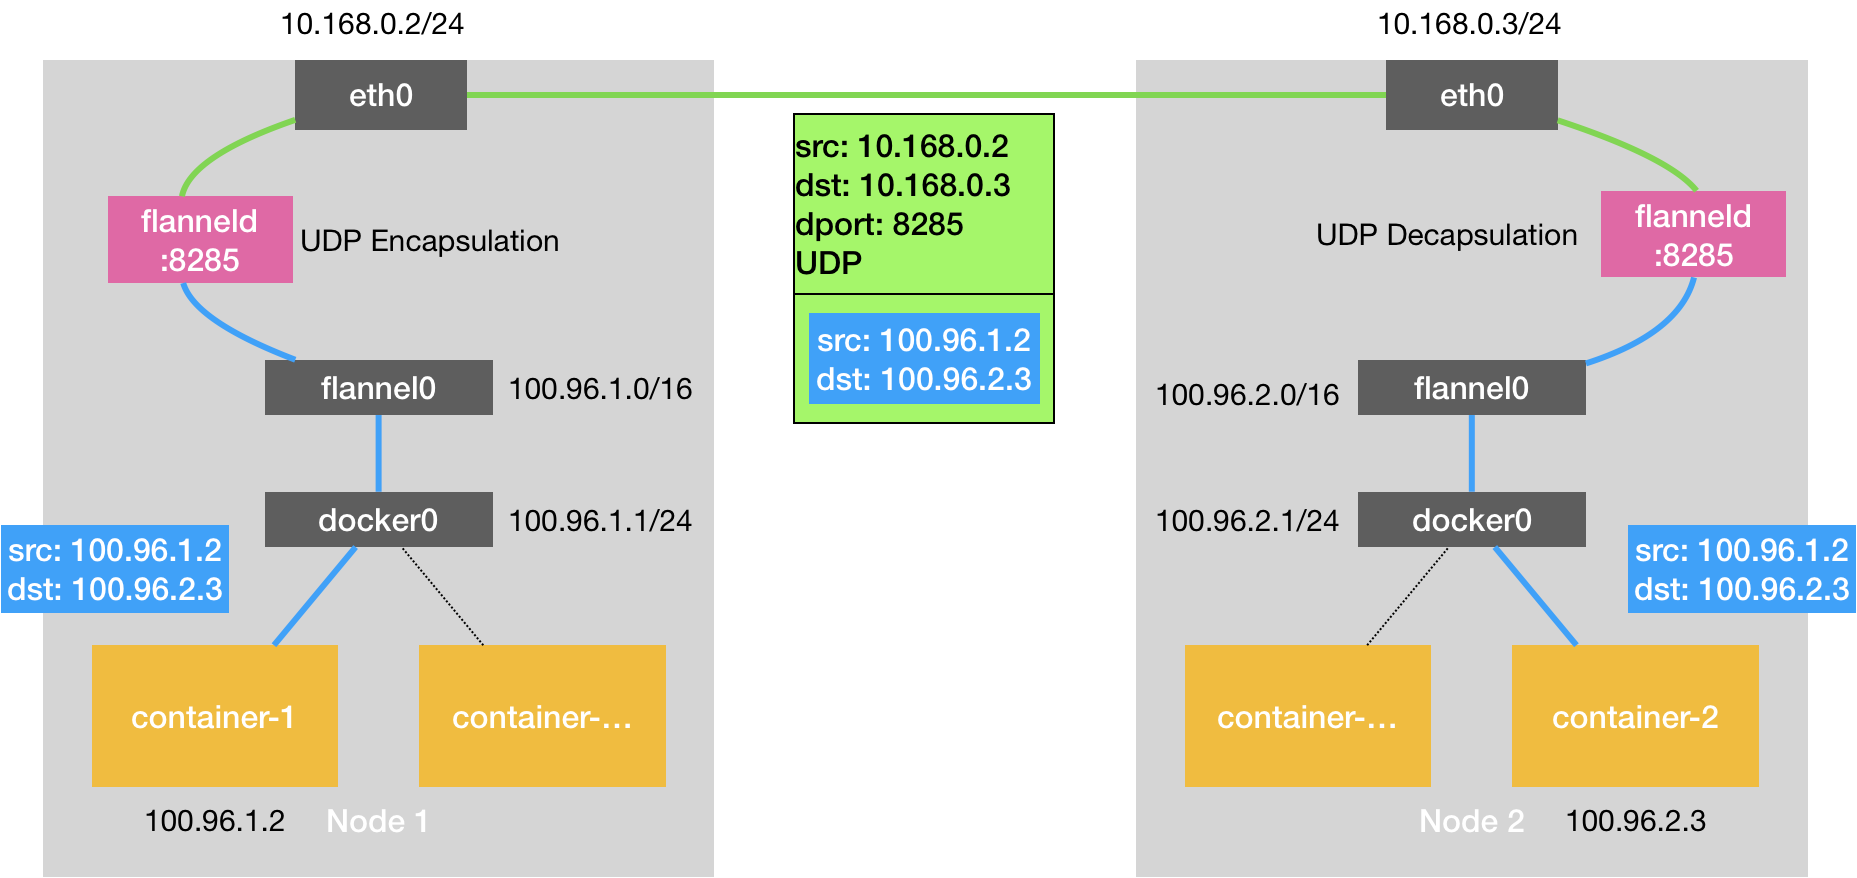
流程:
性能问题:
相比于两台宿主机之间的直接通信,基于 Flannel UDP 模式的容器通信多了一个额外的步骤,即 flanneld 的处理
过程。而这个过程,由于使用到了 flannel0 这个 TUN 设备,仅在发出 IP 包的过程中,就需要经过三次用户态与
内核态之间的数据拷贝,如下所示:

我们可以看到:
第一次:用户态的容器进程发出的 IP 包经过 docker0 网桥进入内核态;
第二次:IP 包根据路由表进入 TUN(flannel0)设备,从而回到用户态的 flanneld 进程;
第三次:flanneld 进行 UDP 封包之后重新进入内核态,将 UDP 包通过宿主机的 eth0 发出去。
此外,我们还可以看到,Flannel 进行 UDP 封装(Encapsulation)和解封装(Decapsulation)的过程,也都是
在用户态完成的。在 Linux 操作系统中,上述这些上下文切换和用户态操作的代价其实是比较高的,这也正是造
成 Flannel UDP 模式性能不好的主要原因
我们在进行系统级编程的时候,有一个非常重要的优化原则,就是要减少用户态到内核态的切换次数,并且把
核心的处理逻辑都放在内核态进行成 Flannel UDP 模式性能不好的主要原因。
VXLAN模式